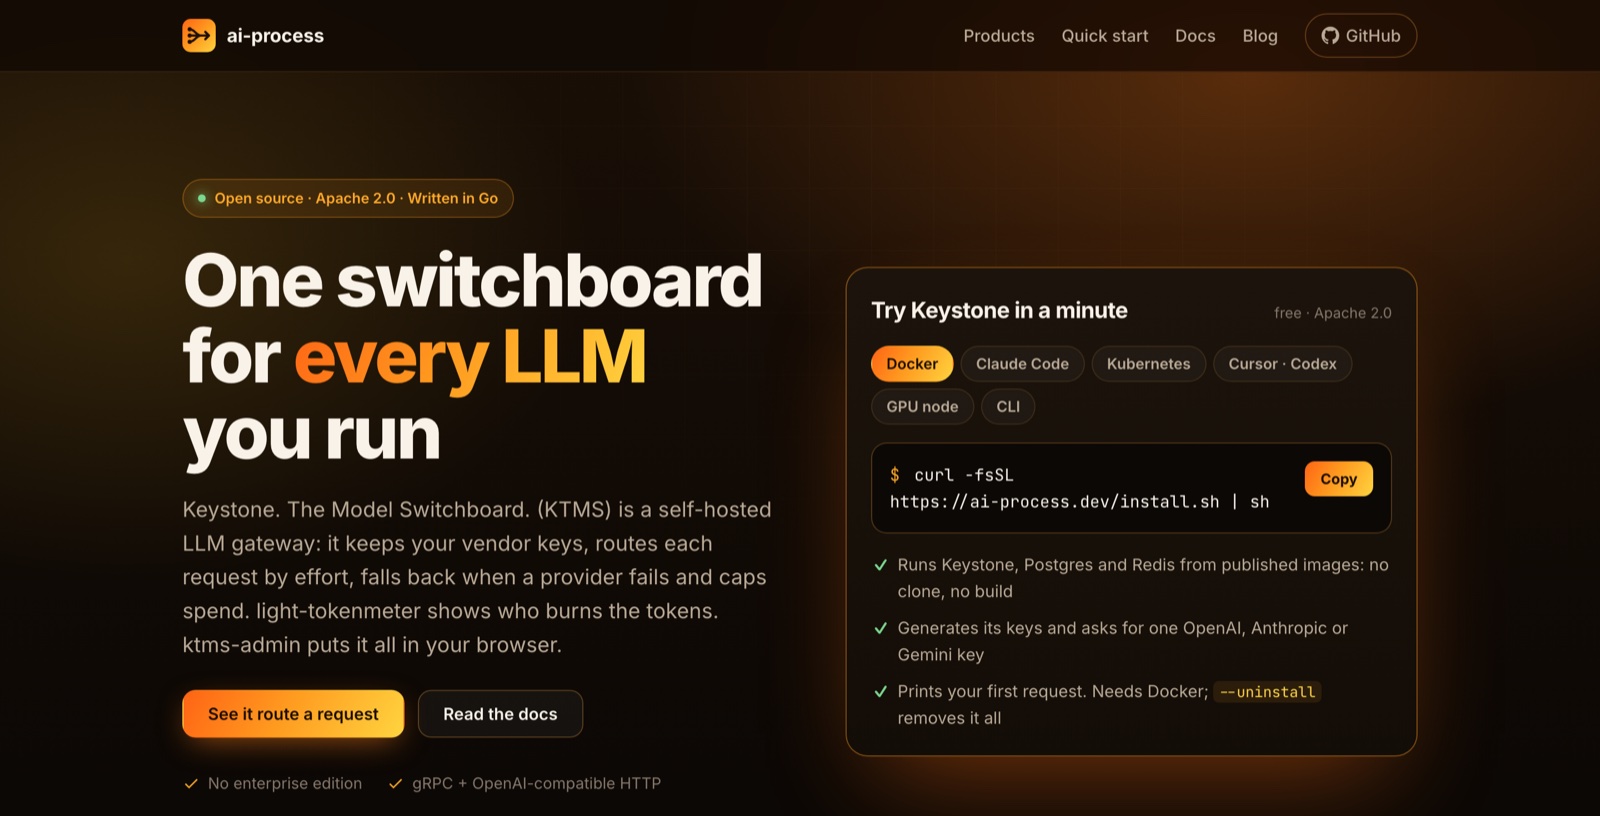
Один шлюз для каждого вызова LLM
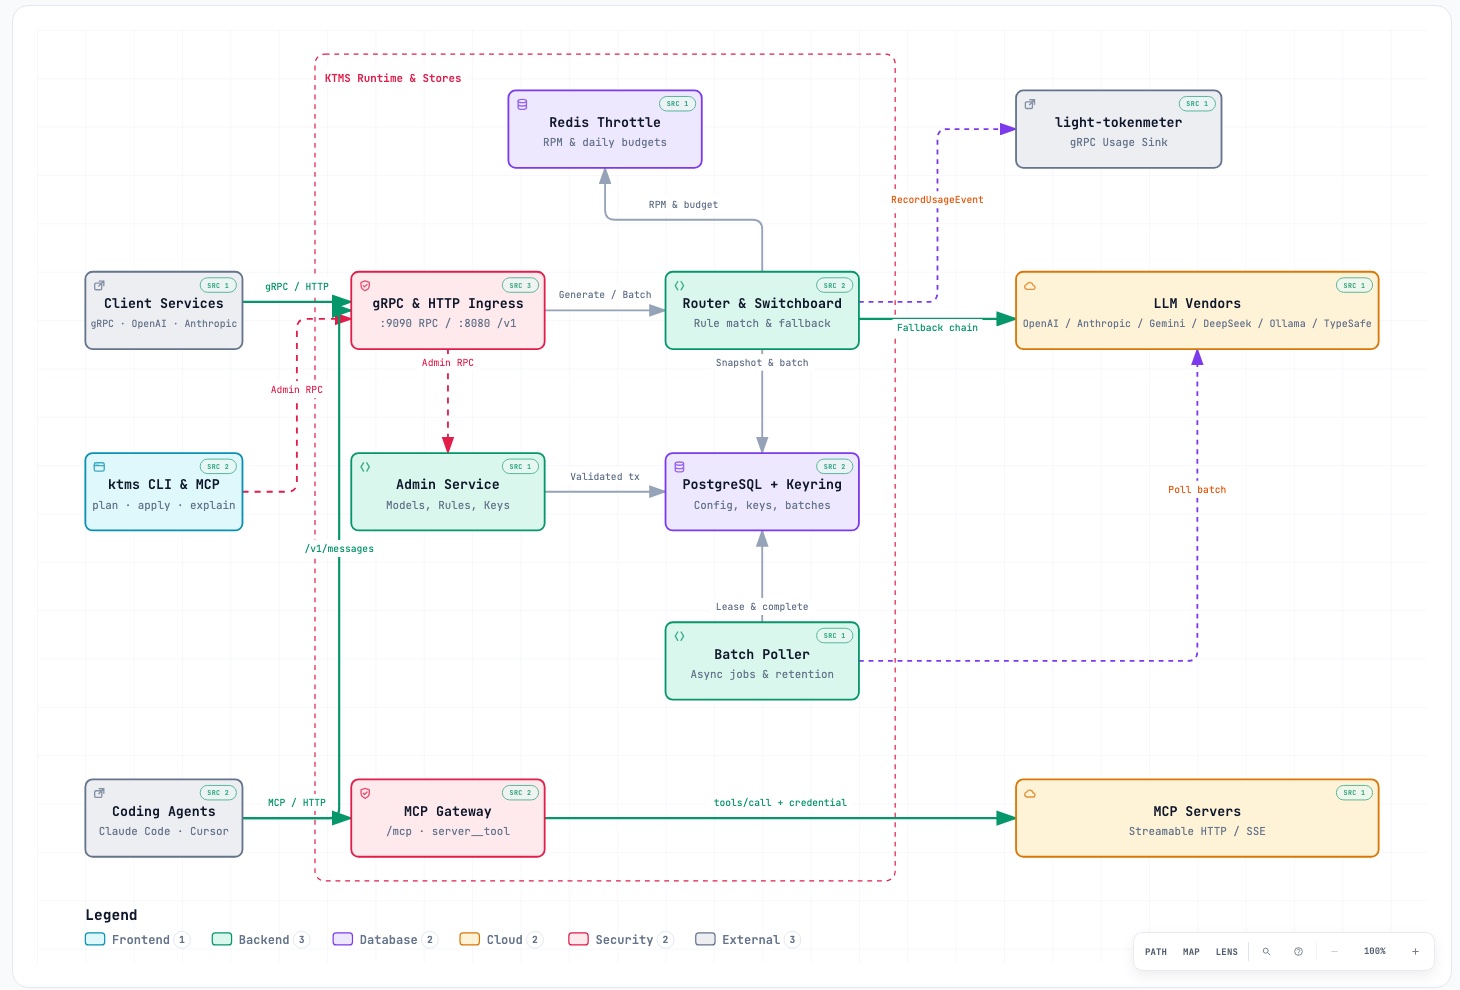
Keystone (KTMS) — open-source LLM-шлюз для self-hosted развёртывания. Сервисы запрашивают уровень усилия, а не модель; Keystone хранит ключи провайдеров, выбирает цепочку моделей, переключается при сбоях и следит за лимитами запросов и расходов.
Он начинался как LLM-прокси внутри snappyloop и стал самостоятельным продуктом, построенным на той же AI-native модели разработки: один Go-бинарник с gRPC, OpenAI- и Anthropic-совместимыми API и MCP-шлюзом, около 7 MiB памяти в простое и меньше миллисекунды добавленной задержки.
Эксплуатационные проблемы LLM в продакшене решаются в шлюзе, а не в каждом сервисе: жёсткие лимиты расходов на ключ, конечного пользователя и команду с атомарным резервированием перед каждым вызовом; circuit breaker на каждого провайдера и цепочки fallback; локальные inference-ноды на простаивающих Mac и GPU-машинах с fallback в облако; подписанные релизы с SBOM и SLSA provenance.
Вокруг него: light-tokenmeter для отчётов об использовании, веб-консоль ktms-admin и плагин для Claude Code, чьи skills оценивают, разворачивают и интегрируют шлюз — с CI, который падает, если skill ссылается на команду, которой нет в релизе.